
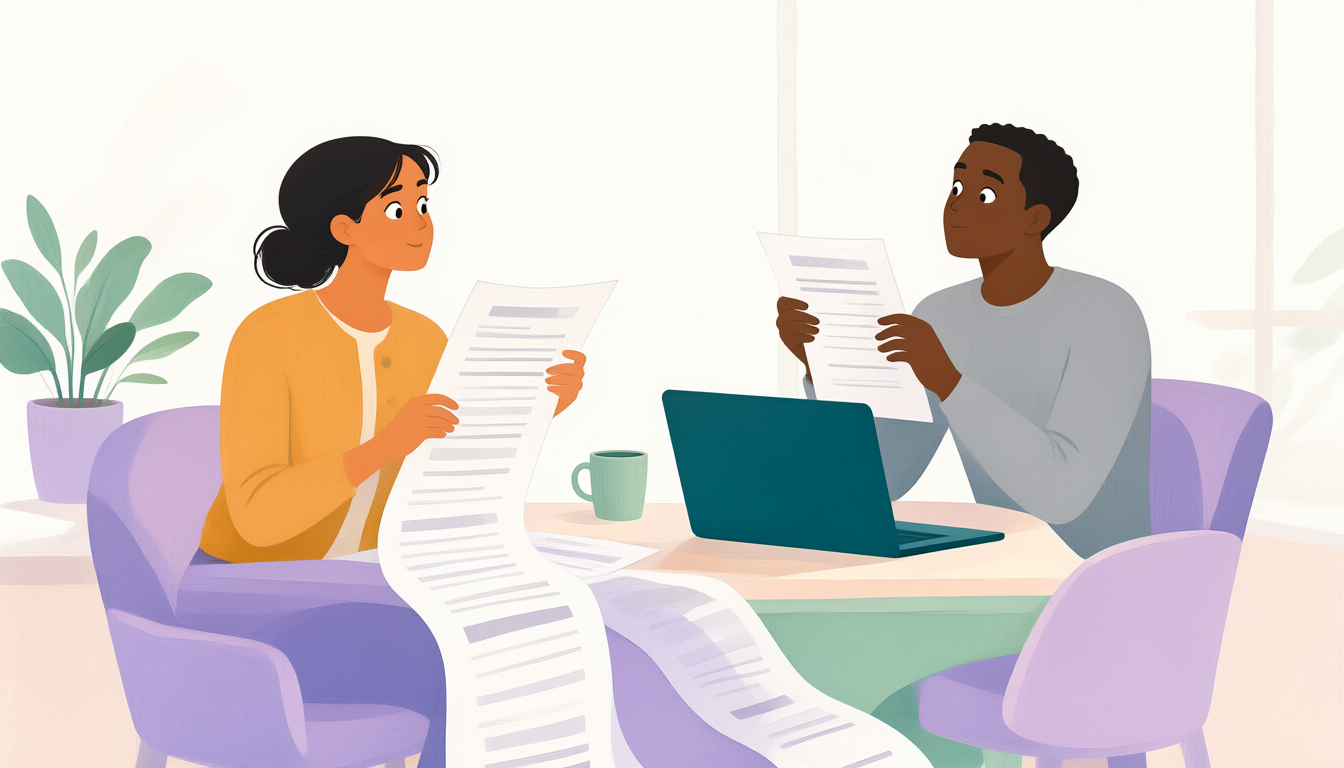
Прія запускає промпт за історією про табелі ENGAGE і отримує одинадцять тест-кейсів. Маркус запускає той самий промпт, на тій самій моделі, того ж дня — і отримує дев'ять: два, яких у неї не було, і без трьох її кейсів. Ніхто з них нічого не змінював.
Опис
Two QA engineers sit at one table with a single teal laptop between them. Priya, on the left, holds a printout so long that it spills across the table; Marcus, on the right, holds a single half-page. They look at each other with raised eyebrows and a half-smile — puzzled, not alarmed. The picture shows that one prompt, sent twice to one model, produced two different test suites. It does not show which suite is correct: neither length is evidence of quality, and both need review.
У тестовому інструменті це дефект. Тут це специфікована поведінка, і тестувальник, який цього не знає, витратить тиждень на те, щоб завести баг на модель.
Чому результат «пливе»
Мовна модель не дістає готову відповідь. Вона раз у раз передбачає наступний токен за розподілом імовірностей — і потім семплює з цього розподілу, а не завжди бере найімовірніший токен. Два запуски проходять двома різними шляхами тими самими ймовірностями, і щойно вони розійшлися на одному токені, кожен наступний токен передбачається з іншої історії.
Опис
A left-to-right pipeline. The prompt is split into tokens, tokens become embedding vectors, the transformer relates every token to every other one, and the result is a probability distribution over the next token. The highlighted step is sampling, where one token is picked from that distribution. The picked token is appended to the output and the whole loop runs again for the next token. The sampling step is where two runs of the same prompt can part ways.
Усю роботу тут виконує слово правдоподібний. Модель породжує текст, статистично ймовірний з огляду на її навчальні дані та ваш промпт. Імовірне — не те саме, що правильне, і ніщо в механізмі цієї різниці не перевіряє.
Зниження температури звужує розподіл, але не перетворює модель на функцію. Навіть за температури 0 провайдери не гарантують однакового виводу від виклику до виклику — пакетна обробка й арифметика з рухомою комою на спільному обладнанні можуть схилити майже рівний вибір між двома токенами в інший бік. Докладно ви розберете це в u15; поки що плануйте варіативність, а не сподівайтеся її вимкнути.
Звідси наслідок, яким ви користуватиметеся весь курс: вивід LLM на тестовому завданні — це свідчення, а не результат. Його перевіряють так, як перевіряли б першу чернетку колеги, — не тому, що модель джуніор, а тому, що з самого виводу не можна сказати, які його частини вона знала, а які сконструювала.
Що модель насправді читає
Ваш промпт потрапляє в модель не словами.
Токенізація розбиває текст на токени. Для звичайної англійської прози робоче
емпіричне правило — близько чотирьох символів, або трьох чвертей слова, на
токен. Ідентифікатори це правило порушують: login, найімовірніше, один токен,
ENGAGE_TIMESHEET_SUBMIT_BTN — найімовірніше, шість або більше. Тестові
артефакти повні ідентифікаторів, стек-трейсів і GUID, тому коштують більше
токенів, ніж підказує кількість слів.
Ембединги перетворюють кожен токен на вектор, розташований так, що токени,
які вживаються схожим чином, опиняються поруч. Тому модель може пов'язати
«елемент надсилання» у вашому промпті з submitButton у вашому коді, хоча їй не
казали, що це одне й те саме, — і тому іноді вона пов'язує дві речі, які лише
схожі на вигляд.
Трансформер — архітектура, яка дає моделі змогу зважувати, як кожен токен співвідноситься з кожним іншим упродовж довгого фрагмента. Завдяки їй модель може тримати в голові всю користувацьку історію цілком, а не читати її рядок за рядком.
Вікно і те, що відбувається на його межі
Контекстне вікно — це скільки тексту, виміряного в токенах, модель може враховувати одночасно: ваш промпт, ваші вхідні дані та її власна відповідь, усе разом. У 2026 році вікна від 128 000 до 1 000 000 токенів — звична річ. Звучить як безліміт, доки не порахуєте:
- регресійний набір із 400 кейсів по ~120 слів на кейс — це ~48 000 слів, приблизно 64 000 токенів, ще до того, як ідентифікатори піднімуть цифру;
- повний лог нічного прогону 2891 — десятки мегабайтів, мільйони токенів. Він не вміщується ніде.
Що відбувається в разі перевищення, залежить від того, з яким шаром ви говорите:
- Безпосередньо через API завеликий запит відхиляється з помилкою довжини контексту. Гучно, і обробити це легко.
- Через чат-інструмент, асистента в IDE або агента вікном керує інструмент. Він може відкинути найраніші репліки, обрізати вкладення, переказати його або дістати лише фрагменти, які вважатиме релевантними, — а потім відповісти рівно з тією самою впевненістю, ніби прочитав усе.
Саме з другим випадком стикаються тестувальники, і він небезпечний: ніщо у відповіді не каже, що частину вводу так і не прочитано. Перевіряйте це, як перевіряли б будь-яке неперевірене твердження: запитайте про те, що, як ви знаєте, міститься наприкінці вводу, або порівняйте кількість падінь, яку називає модель, з кількістю у файлі.
Більше вікно теж не безкоштовне. Більше токенів — більше обчислень, затримки й вартості виклику; до цієї нитки ви повернетеся в u21, коли оцінюватимете, скільки коштує запускати завдання щоночі. А до матеріалу в середині дуже довгого контексту моделі уважні менш надійно, ніж до його початку й кінця: критичне обмеження, заховане на 80 000-му токені, слабше за те саме обмеження на самому верху.
Де розташований GenAI
Вам трапляться чотири терміни, і вони не синоніми. Кожен — підмножина попереднього за тим, як він навчається.
Опис
Symbolic AI stands in its own box on the left: it encodes explicit rules, such as routing defects by keyword. To its right, a frame labelled machine learning contains classical ML — learning from data with features a human chose, such as a severity predictor — and a nested frame labelled deep learning, where the model learns its own features. Inside deep learning sit a screenshot classifier and, highlighted, generative AI, which produces new content such as test cases drafted by an LLM. Dashed arrows name the line crossed at each step: from rules to data, from chosen to learned features, from classifying to generating.
- Символьний ШІ кодує знання як явні правила. Детермінований, прозорий для перевірки, крихкий.
- Класичне машинне навчання навчається на даних, які ви підготували, і ознаках, які ви обрали. Моделі тріажу дефектів зазвичай саме такі.
- Глибоке навчання саме вивчає ознаки на великих наборах даних.
- Генеративний ШІ використовує глибоке навчання, щоб породжувати новий контент — текст, код, зображення, — моделюючи закономірності того, на чому його навчали.
Чому GenAI прийшов у команди тестування, а решта здебільшого ні: він попередньо навчений. Не треба збирати датасет, і немає фази навчання, перш ніж він принесе користь у понеділок. Саме ця зручність і робить юніти про ризики вартими третини цього курсу.
Ще один наслідок «породжує, а не дістає»: якщо інструмент явно не дав моделі документ — через retrieval, вкладення чи конектор, — модель нічого не шукала. Фраза, яка звучить так, ніби її взято з вашої сторінки в Confluence, породжена із закономірностей. Інструменти, які справді отримують матеріал, ви зустрінете в u18 та u19.
Що ви тепер знаєте
Недетермінованість закладена в конструкцію, і температура 0 звужує її, не усуваючи. Токени — це те, що модель читає і за що ви платите, а ідентифікатори дорогі. На межі вікна API падає гучно, а інструмент — тихо. І «правдоподібно» — це справжня мета моделі; правильність — ваша.